¶ RK3588+RK1828实战教程:手把手教你把大模型推理速度提升10倍
¶ 引言
随着端侧AI推理应用的不断深入,RK3588凭借其强大的多媒体处理能力和通用计算性能,已成为嵌入式边缘计算领域的明星平台。然而,其内置NPU仅6TOPS的算力在面对Qwen等大模型的高负载推理时,性能瓶颈逐渐显现:运行3B及以上模型时,推理速度仅60 tokens/秒左右,难以满足实时交互需求。
针对这一痛点,瑞芯微于2025年推出了RK1828端侧AI协处理器。该芯片采用M.2 2280标准形态,通过PCIe接口实现即插即用式算力扩展,搭载20TOPS专用NPU和5GB高带宽DRAM,专门承接高负载AI推理任务。凭借"主控统筹+协处理器专职加速"的异构架构,RK3588+RK1828组合可将大模型推理速度提升至700+ tokens/秒,成为边缘AI大模型部署的理想方案。
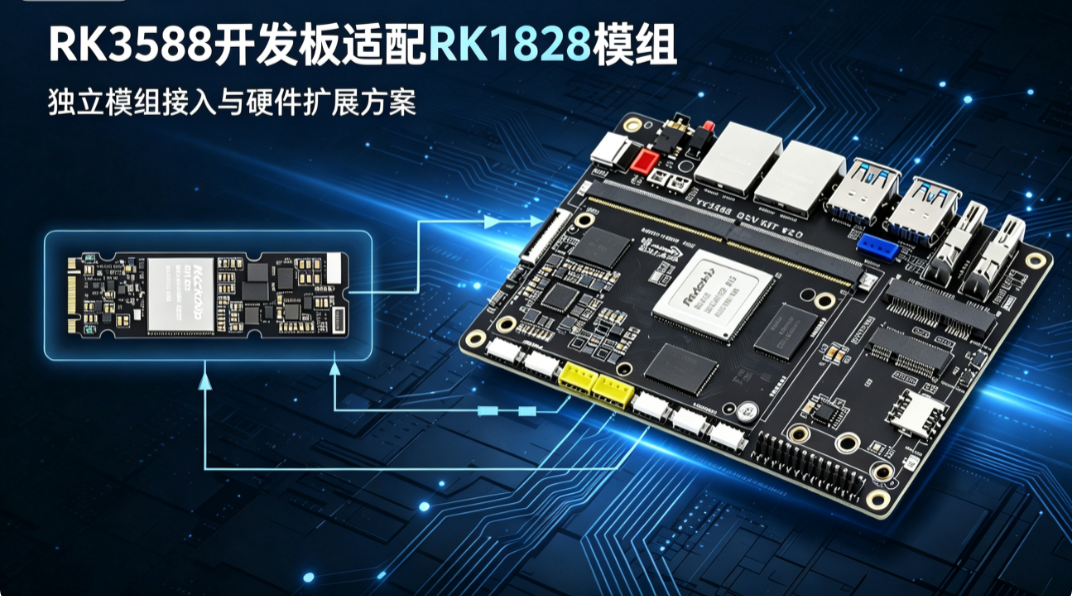
本文将从硬件平台搭建、系统软件适配到推理性能验证,完整记录RK3588开发板上适配RK1828 M.2模组的全过程,并通过大模型对话的实测数据,直观展示RK1828相比RK3588自带NPU的性能提升幅度。
¶ 硬件平台搭建
¶ 硬件选型
本文选用风火轮技术YY3588开发板作为主控平台,该板基于RK3588芯片,采用核心板+底板模块化设计(核心板82×53mm,底板120×88mm),兼具高性能与紧凑体积。
RK3588搭载八核64位CPU(4×Cortex-A76@2.4GHz + 4×Cortex-A55@1.8GHz),集成6TOPS NPU,适合工业控制、边缘AI等多元化应用场景。
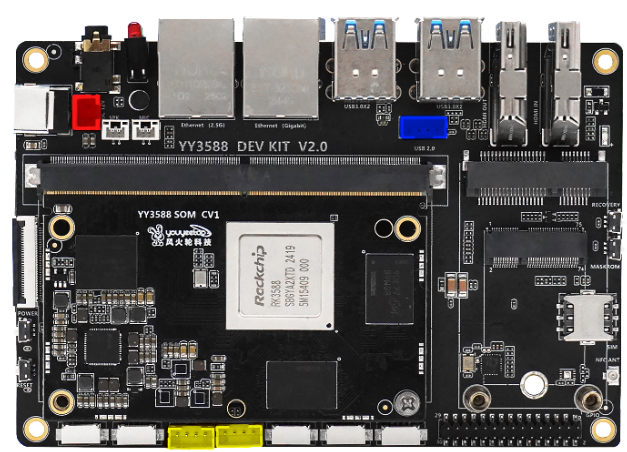
YY3588开发板板载一路M.2 M-Key接口,支持NVMe 2280 SSD固态硬盘,走PCIe 3.0总线。该接口可直接接入本次适配的RK1828 M.2模组。
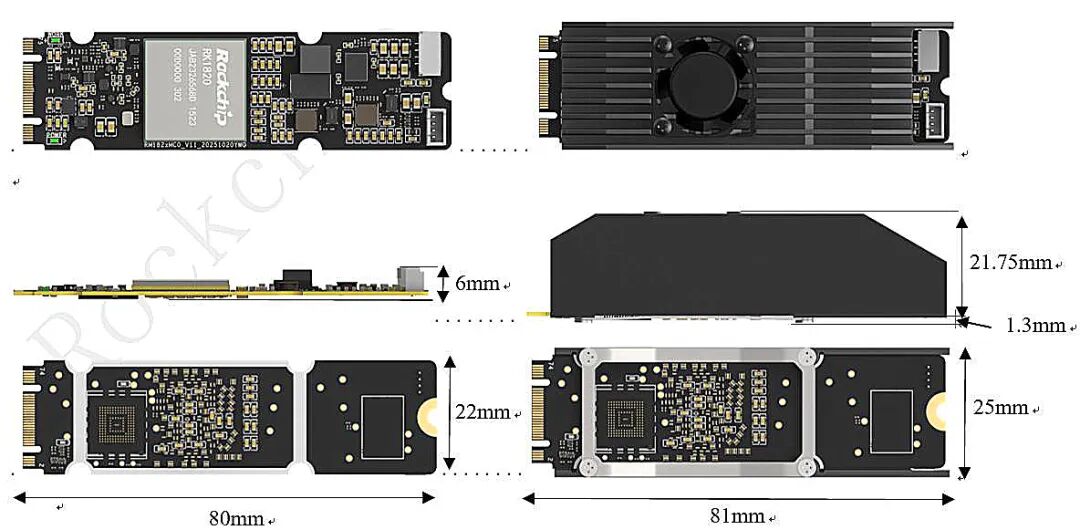
AI协处理器模组选用瑞芯微RM182XMC0。该模组采用M.2 Key B-M连接器,物理尺寸为22mm×80mm×6mm。模组内置RK1828协处理器芯片,基于三核64位RISC-V架构,搭载专用NPU引擎(INT8峰值算力20TOPS)和5GB高带宽DRAM。模组支持PCIe 2.1 ×1接口,数据传输速率最高5.0Gbps。
¶ 硬件安装步骤
¶ 1 检查接口兼容性
确认YY3588开发板的M.2插槽为M-Key规格,支持PCIe 3.0信号。RK1828模组采用Key B-M连接器,两者在物理接口和电气信号上兼容。
¶ 2 安装模组
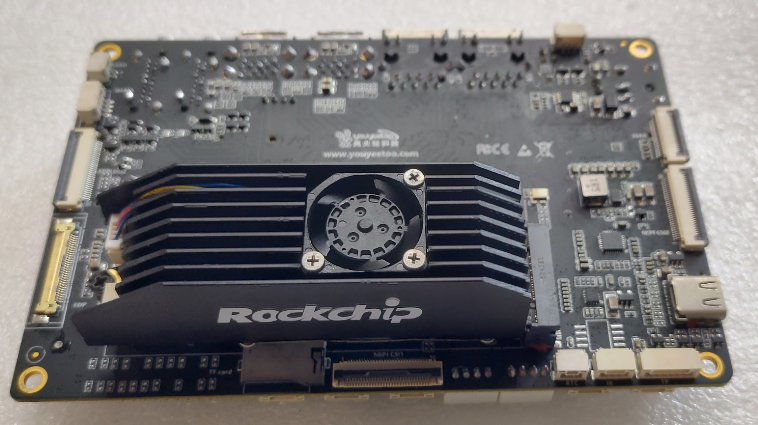
将RK1828模组的金手指对准YY3588开发板的M.2插槽,使用配套螺丝将其固定于底板上的铜柱螺孔。
¶ 3 连接供电
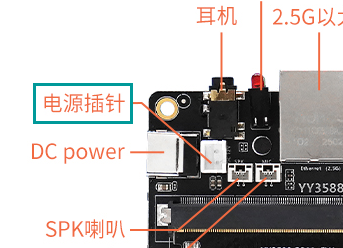
RK1828模组需要独立12V主供电(VCC_IN范围8.0~14.4V,典型值12.0V)。YY3588板载电源插针与DC电源座连通,将RM182XMC0配套电源线插入即可。
⚠️ 注意:预留给RK1828模组应至少达到 2A,否则可能无法启动。
¶ 4 上电启动
完成上述安装后,为YY3588开发板上电,系统正常启动。此时,RM182XMC0上的风扇也会转动。
¶ 硬件识别验证
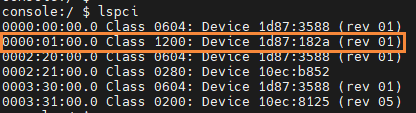
系统启动后,在YY3588开发板的串口通过以下命令验证RK1828模组是否被正确识别:
lspci
预期输出中应出现VID为 1d87、PID为 182a的设备。
¶ 常见问题排查
¶ 问题1:RM182XMC0风扇不转,指示灯不亮
检查12V电源是否接反,电源电流是否足够。预留给RK1828模组应至少达到2A,不然可能出现不开机的情况。
¶ 问题2:RM182XMC0上电后PCIe无法识别
检查一下dmesg里面是否有报错信息,正常情况下,会是这样的信息:
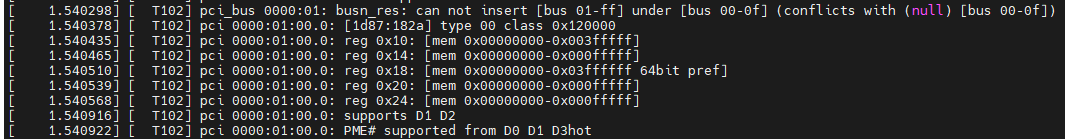
▸ 若枚举失败,检查模组是否插紧(可能存在接触不良)
¶ 软件适配(基础部署)
系统软件层面的适配工作,主要包括内核驱动配置、RK1828固件与运行时库的安装部署,以及环境验证。本章基于瑞芯微官方提供的**RK1820/RK1828 AI SDK(Release V1.1.0)**进行说明。
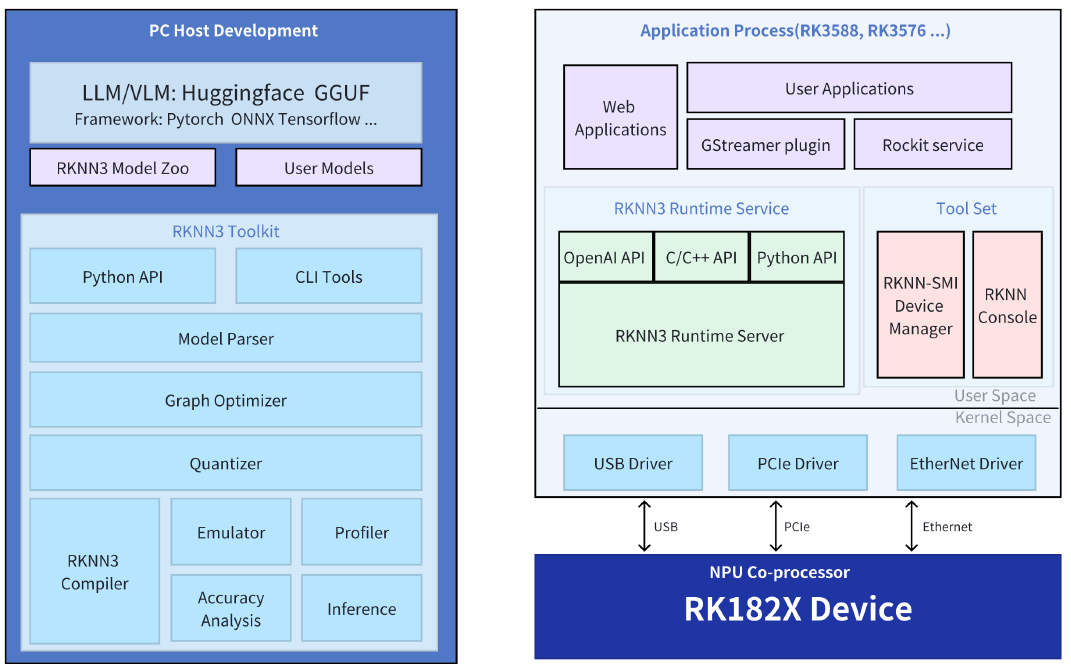
RK1828 SDK框架图
此SDK框架与RK3588的RKNN2类似,均包含PC端的RKNN Toolkit与主控端的RKNN Runtime。不同之处在于:使用RK1828时,主控需加载USB/PCIe/Ethernet驱动与协处理器通信。M.2接口的RK1828模组通过PCIe通道连接。
¶ 系统与环境准备
Host端系统要求:
本文使用的YY3588开发板,开发板上安装android系统。要使用RK1828的PCIe驱动,要求内核版本需不低于5.10。
SDK获取:
从瑞芯微官方渠道获取RK1828 M.2模组对应的预编译软件安装包 rknn3_rk182x_m2_v1.1.0_installer_arm64.tgz。该安装包包含了RK1828固件、RKNN3 Runtime、调试工具集(rknn-smi、rknn-console)等。
¶ 内核驱动配置
内核驱动配置有如下两个方法,任选其一:
¶ 方法1:自行编译内核
若需自行编译内核以启用PCIe EP功能支持,需在Rockchip SDK内核源码中确认已合入相关补丁。对于Linux kernel 6.1版本的SDK,补丁说明如下:
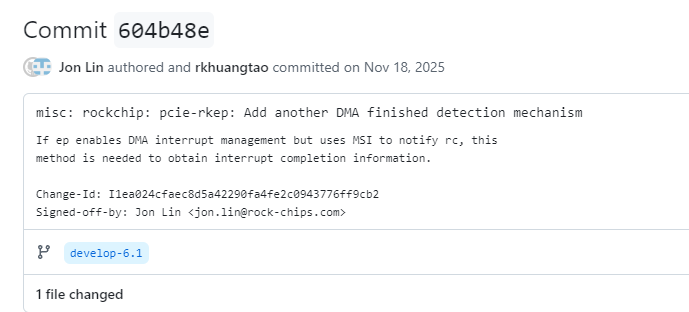
此补丁只是改了 drivers/misc/rockchip/pcie-rkep.c 文件,单独把这个文件拉下来放SDK里面替换也是可以的。
并确认开启以下内核配置项:
CONFIG_PCIE_FUNC_RKEP=y
CONFIG_PCIE_DW_DMATEST=y
配置完成后重新编译内核并烧录至YY3588开发板。
¶ 方法2:使用预编译驱动
RK也提供了一个单独抽出来的rkep驱动文件夹,此文件夹内容如下:
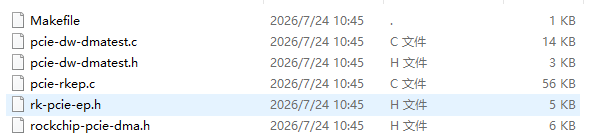
将这几个文件放到 drivers/misc/pcie-rkep 目录下面,然后修改 drivers/misc/Makefile,增加一行:
obj-y += pcie-rkep/
然后重新编译内核,即可得到 drivers/misc/pcie-rkep/pcie-rkep.ko 文件,将此文件通过adb等方式推到板端,并执行:
insmod pcie-rkep.ko
验证驱动加载:
无论采用上述哪种方式,成功加载后,都可以看到如下dmesg信息:
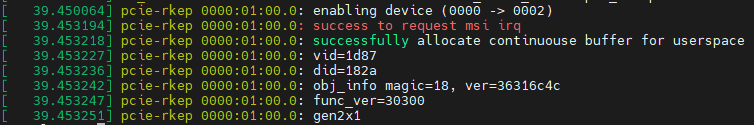
同时 /dev 目录下出现 pcie-rkep-XXXX:XX:XX.X 节点,其中 XXXX:XX:XX.X 取决于使用的PCIe端口号。
¶ RKNN3 Runtime配置
解压 rknn3_rk182x_m2_v1.1.0_installer_arm64.tgz 后,得到如下内容:
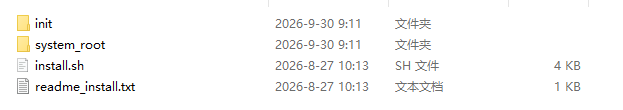
这里面包含了Linux和Android两个平台的二进制可执行程序和动态库。下面仅以Android的部署方式为例说明,Linux是类似的。
¶ 1 加载RK182X固件
RK182X模组没有存储器,固件是放在合封的DDR里面运行的,因此每次上电,都需要主控把它的固件发过去。
固件路径:
system_root/firmware/rknn3_rk1820_ext-m2.img
下载工具:
system_root/bin/pcie_upgrade_tool(主控运行 Linux 和 Android 时一样)
将固件和下载工具放到板上,然后执行:
pcie_upgrade_tool uf rknn3_rk1820_ext-m2.img -reset
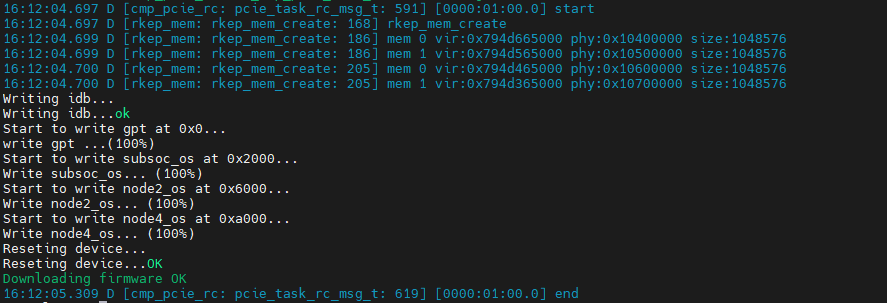
⚠️ 注意:下载固件前,RK182X风扇处于最高转速;下载固件后,RK182X在温度较低时,风扇会处于低转速或者不转,即动态调温策略会生效。
¶ 2 部署动态库
Android系统:
动态库位于 system_root/lib/MultiSys/Android/ 文件夹,把这个文件夹里面所有文件推到板端的 /vendor/lib64 即可。
Linux系统:
动态库位于 system_root/lib/ 文件夹,把这个文件夹里面 .so 后缀的文件推到板端的 /usr/lib64 即可。
¶ 3 验证环境
可将 system_root/bin/rknn-smi(Linux)或 system_root/bin/MultiSys/Android/rknn-smi(Android)推到板上,执行:
rknn-smi -v
如果配置正确,能看到如下打印信息:
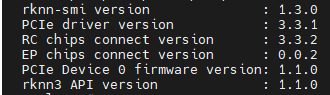
⚠️ 注意:PCIe Device 0 firmware version 是RK182X的固件版本,rknn3 API version 是主控端动态库版本,二者必须一致。
¶ 4 启动传输服务
主控和RK182X之间需要传递模型数据等,这里需要使用到 rknn3_transfer_proxy 工具。
# Linux
system_root/bin/rknn3_transfer_proxy

# Android
system_root/bin/MultiSys/Android/rknn3_transfer_proxy
将这个文件推到板上,直接执行:
rknn3_transfer_proxy &
此时使用 netstat 命令可以看到如下两个端口被打开了:

✓ 至此完成 runtime 部署
¶ RK1828大模型对话功能演示
与RK3588/RK3399PRO平台一样,通用模型需转换为RKNN格式后才能在板端NPU运行。本文以瑞芯微官方预训练的Qwen2.5-3B模型为例进行演示。下载模型后,可以得到如下四个文件,把这四个文件推到板上:
Qwen2.5-3B.rknn
Qwen2.5-3B.weight
Qwen2.5-3B.tokenizer.gguf
Qwen2.5-3B.embed.bin
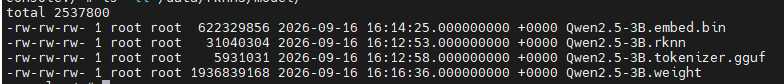
然后需要使用瑞芯微提供的一个 openAI server 端软件,这样可以通过 openAI 接口与之对话。
- Linux 路径:
system_root/bin/rkllm3-server - Android 路径:
system_root/bin/MultiSys/Android/rkllm3-server
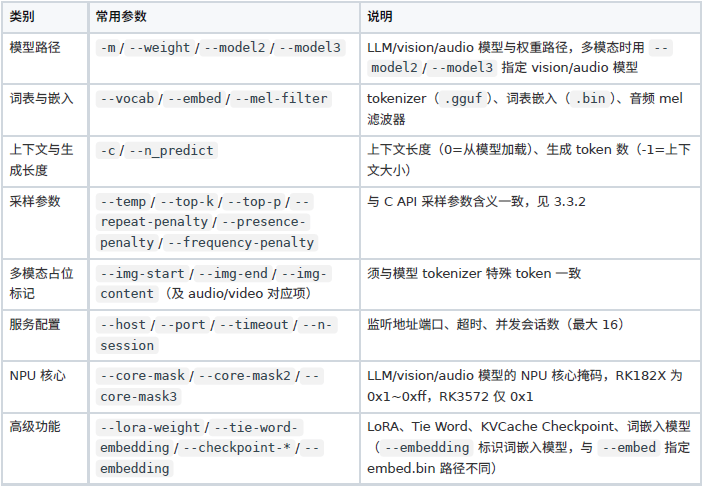
将这个文件推到板上,执行:
rkllm3-server -m /xxx/Qwen2.5-3B.rknn \
--weight /xxx/Qwen2.5-3B.weight \
--vocab /xxx/Qwen2.5-3B.tokenizer.gguf \
--embed /xxx/Qwen2.5-3B.embed.bin \
--host 0.0.0.0 --port 8080 -c 768 \
--n_predict 512 --repeat-penalty 1.1 \
--presence-penalty 1.0 --frequency-penalty 1.0 \
--top-k 1 --top-p 0.8 --temp 0.8
这些参数的定义如下:
执行之后,可以用 netstat 看到有如下端口被打开了:
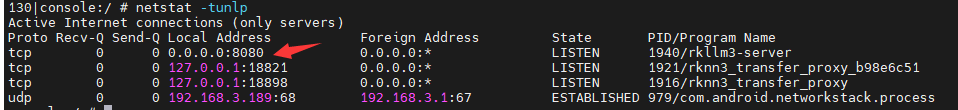
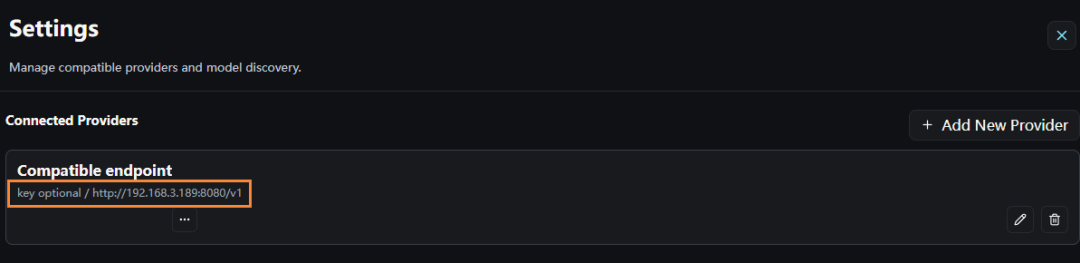
部署完成后,可以使用 Navi 这款工具与RK3588上面开放出来的 openAI 兼容端口连接。Navi 的配置如下所示,IP 填入 YY3588 板子的 IP,PC 要跟板子在同一局域网。
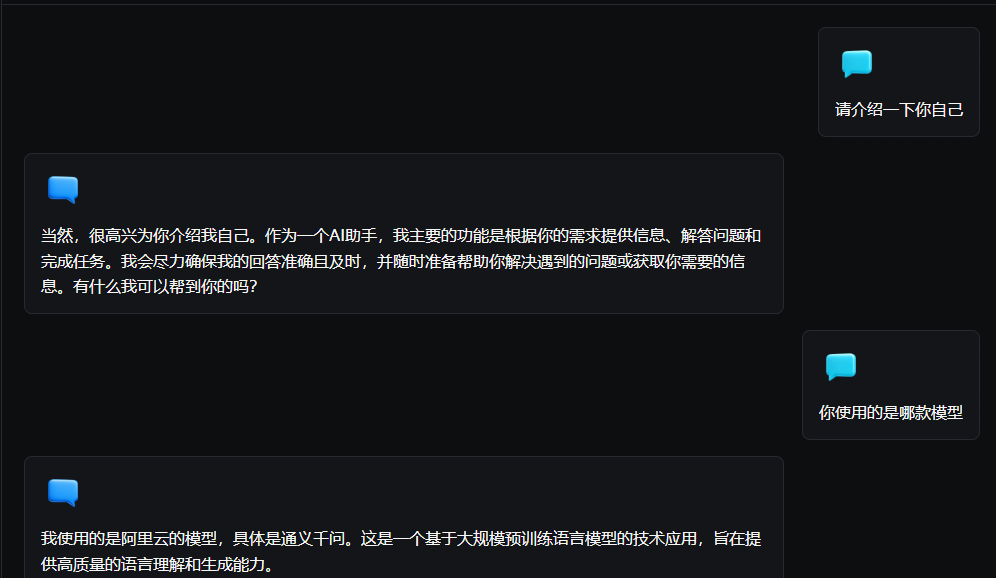
然后发起对话:
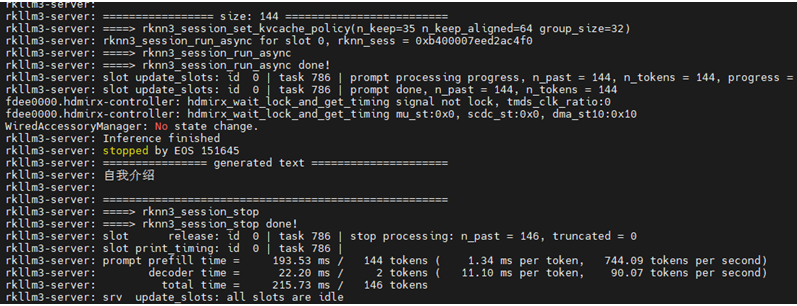
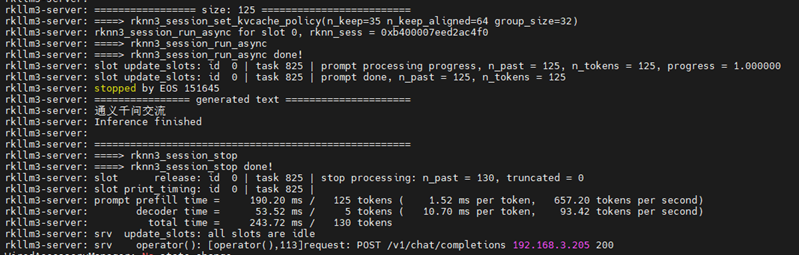
对话之后,在 logcat 日志里面,可以看到其运行耗时、消耗的 token 等信息:
¶ 性能对比分析
从日志可以看到,RK3588+RK1828平台运行3B模型时,prompt prefill速度高达700+ tokens/秒。作为对比,RK3588单独运行1.5B模型时仅能达到60 tokens/秒左右。
| 平台配置 | 模型规模 | 推理速度 |
|---|---|---|
| RK3588(6TOPS NPU) | 1.5B | ~60 tokens/秒 |
| RK3588+RK1828(20TOPS NPU) | 3B | 700+ tokens/秒 |
🚀 性能提升超过10倍,充分验证了"主控+协处理器"异构架构在大模型推理场景下的显著优势。
¶ 结语
本文从硬件连接、系统配置、驱动加载、软件部署到最终的推理性能验证,完整记录并分享了在RK3588(YY3588)平台上适配RK1828 M.2 AI协处理器的全过程。
通过实测数据可以直观地看到,RK3588与RK1828的"主控+协处理器"异构架构带来了显著的性能飞跃。在运行3B参数规模的大模型时,RK1828凭借20TOPS专用NPU算力与5GB高带宽DRAM,将推理速度提升至700+ tokens/秒,彻底解决了RK3588自带6TOPS NPU在大模型推理时的性能瓶颈。
随着端侧AI向更大参数量、更高实时性方向演进,RK1828 M.2模组以其标准化的接口、即插即用的算力扩展能力,为边缘计算设备提供了一条极具性价比的升级路径。未来,我们期待基于该异构平台,进一步探索多模态大模型、端侧Agent等更复杂的应用场景,充分释放边缘AI的潜力。
关于风火轮技术 Youyeetoo
专注于嵌入式开发板和边缘AI解决方案,为开发者提供高性能、高性价比的硬件平台和技术支持。
🌐 官网:youyeetoo.com
📖 技术 Wiki:wiki.youyeetoo.com